Vybrané statistické pojmy
|
Alternativní hypotéza (viz též
Testování
hypotéz) |
Je předpoklad
opačný k nulové hypotéze. Podle alternativní hypotézy nejsou zjištěné rozdíly
mezi porovnávanými statistickými charakteristikami výsledkem náhody, ale jsou
ovlivněny určitým systematicky působícím faktorem. |
||||||||||||||||||
|
Analýza rozptylu |
Je statistická
metoda, která umožňuje zkoumat vliv různých faktorů na studovaný znak.
Spočívá v rozložení celkového rozptylu na rozptyl ovlivňovaný určitým
faktorem (určitými faktory) a na rozptyl reziduální (zbytkový). |
||||||||||||||||||
|
Aritmetický průměr (viz též
Statistické
míry polohy) |
Je jedním ze statistických průměrů. Je (mimo jiné) i typickou
nejpravděpodobnější hodnotou statistického souboru s tzv. normálním
(Gaussovým) rozdělením. Je též nejlepším vyjádřením výsledků série měření.
Vypočítá se tak, že se součet všech hodnot statistického znaku (jednotlivých
výsledků měření) dělí jejich počtem. Matematicky je aritmetický průměr
vyjádřen takto:
kde xi může
být například výsledek jednotlivého měření z celkového počtu n měření |
||||||||||||||||||
|
Binomické
rozdělení |
Je celočíselné rozdělení pravděpodobnosti, které slouží jako model
k analýze nominálních znaků alternativního typu. Obecný zápis, že pro
pravděpodobnost jevu A, že z (n) pokusů nastane právě jev A a právě k-krát (a
tedy (n - k)krát jev
kde je:
p ... pravděpodobnost jevu A n ... počet pokusů k ... počet
výskytů jevu A |
||||||||||||||||||
|
Bodový odhad |
Bodový odhad
určitého statistického parametru základního souboru je takový odhad, kdy parametr
základního souboru odhadujeme jediným číslem (bodem) – výběrovou
charakteristikou. Např. průměr základního souboru odhadujeme pomoci průměru
výběrového souboru. |
||||||||||||||||||
|
Hladina (úroveň)
významnosti (obvykle značená alfa |
Udává pravděpodobnost, že bude
mylně zamítnuta platná nulová hypotéza (pak tedy pravděpodobnost mylného
zamítnutí této hypotézy je alfa). Udává pravděpodobnost tzv. statistické
chyby I. druhu |
||||||||||||||||||
|
Hypotéza statistická (viz též Testování hypotéz) |
Je hypotéza (předpoklad), kterou je možno testovat statistickým
postupem. Jsou to domněnky, které se týkají parametrů a rozdělení
statistických základních souborů a které se ověřují zkoumáním výběrových
souborů. Rozdíl mezi jednostrannou a dvoustrannou hypotézou nebo
jednostranným či dvoustranným statistickým testem na určité hladině
významnosti udává tabulka kritických mezí (pro testy založené na
standardizovaném normálním rozložení a = 1 - b) když platí:
|
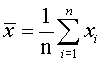

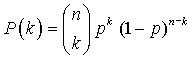

|
Intervalový odhad |
Intervalový odhad určitého statistického
parametru základního souboru se nazývá odhad pomocí číselného intervalu, ve
kterém se odhadovaný parametr nachází s určitou pravděpodobností. |
|
Kontrolní cyklus (replikační
experiment) |
Je časové údobí určující -
zahrnující cyklus (sadu) jednotlivých nezávislých rutinních měření
kontrolního materiálu - vzorku (minimálně |
|
Korelace (viz též Koeficient
korelační) |
Je pojem, který nemá jednoznačný význam. Ve statistice se tohoto pojmu
zpravidla používá k označení vztahu mezi dvěma nebo více statistickými
kvantitativními znaky pozorovanými na statistickém souboru např. mezi věkem a
koncentrací analytu v krevní séru aj. Poznámka: závislost mezi kvalitativními
statistickými znaky se nazývá asociace. Pro kvantifikaci míry závislost dvou náhodných proměnných se užívá
korelační koeficient rxy, který nabývá velikosti od -1 do +1
(je-li |rxy| = 1, jsou náhodné proměnné zcela závislé -
korelované; jsou-li proměnné nezávislé, je rxy = 0). Pro
množinu párů dat (statistických znaků) (xi, yi)
spočteme kovarianci:
a korelační koeficient rxy je pak roven:
kde sx
a sy jsou směrodatné odchylky souborů dat xi a yi
pro i = 1,2,3,…n (např. série měření). |
|
Kritická oblast |
Kritická
oblast statistického testu je oblast, ve které dochází k zamítání nulové
hypotézy a k přijímání hypotézy alternativní. |
|
Kvantil |
Je hodnota, pod kterou
leží specifikovaná část rozdělení. Kvantily (kvartily, decily, percentily)
vydělují stejně obsazené části se stejnou relativní četností. Některé
kvantily mají specifická jména: K1/2 je medián, K1/4
značí dolní kvartil, Ki/100 i-tý percentil, který dělí statistický
soubor na sto stejně početných částí aj. |
|
Kvartily |
Kvartil vychází z
pojmu kvantil a používá se pro jednoduchý popis souboru dat. Obdobně jako je
medián prostředním prvkem uspořádané množiny prvků od xmax k xmin,
horní kvartil (značí se Kh) prostředním prvkem mezi mediánem a xmax
a dolní kvartil (značí se Kd) prostředním prvkem mezi xmin a
mediánem. Kvartily tedy oddělují z každého kraje uspořádané množiny prvků 25%
a mezi nimi leží 50% prvků uspořádaného souboru dat. |
|
Medián (viz též Statistické míry polohy) |
Je 50% kvantil, tedy prvek, který
leží uprostřed uspořádaného statistického souboru. Jedná se velmi silnou
statistickou veličinu a v některých případech se používá místo
aritmetického průměru. Při lichém počtu (n) pozorovaných
statistických jednotek je medián prvek s pořadovým číslem (n+1)/2. Při sudém počtu (n) pozorovaných
statistických jednotek sledovaného znaku je medián aritmetický průměr dvou
prvků s pořadovými čísly n/2 a n/2+1. |
|
Modus (viz též Statistické
míry polohy) |
Je hodnota proměnné veličiny
(statistického znaku) v souboru, která se v souboru vyskytuje
nejčastěji. |
|
|
Je nejčastěji používané modelové
rozdělení. Je definováno dvěma parametry – střední hodnotou µ a rozptylem
sigma. Jeho grafickým vyjádřením je známá symetrická křivka zvonovitého
tvaru. Jeho význam je značný. Velká část kvantitativních znaků, které jsou předmětem
zkoumání biologických věd, má normální rozdělení nebo rozdělení, které jde na
normální přetransformovat. U hodnot statistického znaku, které mají normální
rozdělení, platí, že 95% hodnot znaku se přibližně nachází v rozmezí
aritmetický průměr ± dvojnásobek směrodatné odchylky. Základní význam má
normální rozdělení též v teorii výběrových šetření. Hustota
pravděpodobnosti nebo-li frekvenční funkce Gaussova rozdělení je vyjádřena
rovnicí:
kde sigma je směrodatná odchylka
a µ střední hodnota Mimořádný význam normálního
rozdělení tkví rovněž v tom, že součet n nezávislých a jakkoli rozdělených
náhodných veličin má přibližně normální rozdělení (Ljapunovova věta). |
|
Nulová hypotéza
(obvykle značená H0, viz též Testování hypotéz) |
Je předpoklad, že
srovnávané statistické charakteristiky se od sebe liší pouze jako následek
náhodných změn statistických znaků na srovnávaných statistických souborech
(jinými slovy: pozorování mají shodné rozdělení, i když byla získána za
různých podmínek). |
|
Neparametrické metody (viz též Testy hypotéz parametrické a
neparametrické) |
Jsou statistické metody (zejména
testy), které se netýkají parametrů rozdělení, ale jsou odvozeny
z takzvaných statistických pořadových měr. Jsou početně jednoduché a
použitelné pro popis různých typů rozdělení. V případě, že se jich
použije pro analýzu souborů normálně rozdělených, dávají méně informací než
parametrické metody. |
|
Parametr
statistického souboru |
Je určitá zevšeobecňující
charakteristika základního souboru (aritmetický průměr, směrodatná odchylka
aj.). |
|
Parametrické metody (viz též Testy hypotéz parametrické a
neparametrické) |
Jsou statistické
metody založené na zkoumání zevšeobecňujících statistických charakteristik
souborů, tak zvaných parametrů (průměrů, rozptylů aj.) rozdělení. Vycházejí
zpravidla z předpokladu, že sledovaný znak má normální – Gaussovo
rozdělení. |
|
Poissonovo
rozdělení (rozložení) |
Je celočíselné rozdělení, které
slouží jako modelové rozdělení pro popis číselných znaků nespojitého -
diskrétního tvaru. Používá se rovněž jako aproximace binomického rozdělení
pro případ, že rozsah souboru je velký a pravděpodobnost výskytu sledovaného
jevu malá. Poznámka: Poissonovo rozdělení se s výhodou používá pro
hodnocení testovacích proužků, některých POCT metod atd. Pro nespojitou
náhodnou veličinu X nabývá Poissonovo rozložení pouze celočíselných hodnot x
= 0, 1, 2…. Má jediný parametr rozložení lambda, který odpovídá střední
hodnotě i rozptylu. Pravděpodobnost výskytu hodnot x = 0,1,2… je dána
rovnicí:
kde |
|
|
Je číselná míra pro hodnocení
možností výskytu určitého náhodného jevu (náhodné veličiny). Tato míra se
pohybuje v intervalu hodnot <0; 1> (0 = nemožný jev, 1= jistý
jev). |
|
Regrese |
Je v obecném smyslu jednostranná
kvantitativní závislost tj. je při ní apriorně určena závisle proměnná a nezávisle
proměnná. |
|
Rozdělení
statistického souboru |
Je tabulka, ve
které jsou ve vzestupné posloupnosti uvedeny hodnoty statistického znaku a
jim odpovídající absolutní nebo relativní četnosti. Rozdělení mohou být
teoretická (modelová), nebo empirická. Ta jsou zjištěna jako výsledek pokusů
nebo pozorování. |
|
Rozptyl (značí se s2 nebo sigma2) (viz též Statistické
míry rozptylu) |
Je jedním ze základních parametrů
statistického souboru. Určí se např. dle vzorce:
kde xi je pro i
=1,2….n hodnota statistického znaku (např. výsledek jednotlivého měření) a |
|
Směrodatná odchylka (značí se s nebo sigma) (viz též Statistické míry rozptylu) |
Je často používaná statistická charakteristika pro měření rozptýlenosti
(variability) jednotlivých hodnot statistického znaku kolem aritmetického
průměru. Vypočítá se jako kladná druhá odmocnina z rozptylu dle vzorce:
kde |
|
Statistická
jednotka |
Je prvkem
statistického souboru (vzorek krve, vzorek moči, pokusné zvíře atd.), na
kterém je zkoumán jeden nebo více statistických znaků. |
|
Statistický
soubor |
Je množina
statistických jednotek s přesně vymezenými znaky (vlastnostmi). |
|
Studentovo
rozdělení (někdy též "Studentovo t - rozdělení") |
Je spojité rozdělení náhodné
veličiny symetricky rozdělené kolem t = |
|
Stupeň volnosti |
Udává počet
nezávislých srovnání, která je možno provést v daném souboru. Je to
pojem, který nelze zcela jednoduše vysvětlit. Uvažujme, že jsme u 20 osob
měřili koncentraci glukózy v krevním séru. Soubor má 20 stupňů volnosti,
protože žádné jednotlivé měření – pozorování neovlivňuje výsledek ostatních
19 měření (zanedbáváme preanalytickou a analytickou chybu). Jestliže však
vypočítáme aritmetický průměr xpr z 20ti prvků souboru, bude
mít n – 1 (tj. 19) stupňů volnosti, protože dvacátá hodnota v souboru se
již nemůže volně měnit, má-li být zachována velikost průměru. |
|
Střední hodnoty (viz též
Statistické
míry polohy) |
Jsou
zevšeobecňující statistické charakteristiky, které vyjadřují typickou
vlastnost statistického souboru. Dělí se na průměry a ostatní střední
hodnoty. |
|
|
Statistický test používaný
zejména k ověřování statistické významnosti rozdílů mezi rozptyly dvou
nebo více výběrových souborů. |
|
(někdy též
Studentův test) |
Jeden z nejčastěji používaných
statistických parametrických testů pro ověřování významnosti rozdílů mezi
výběrovým průměrem a průměrem základního souboru. |
|
|
Je test, kterého se používá
především při testování rozdílů mezi výběrovým rozptylem a rozptylem
základního souboru. |
|
Třídění
(statistické) |
Je uspořádání statistického
souboru do vymezených skupin – tříd podle určitého znaku (jednostupňové
třídění), nebo podle více znaků současně (vícestupňové třídění). |
|
Výběrový statistický
soubor |
Tvoří část
jednotek základního souboru a je vybraný takovým způsobem, aby výběrový
soubor spolehlivě reprezentoval základní soubor. |
|
Základní
statistický soubor (často označovaný populace) |
Tvoří úplná množina statistických
jednotek, které jsou předmětem studia. Může být velmi rozsáhlý nebo až
nekonečně velký. |
|
Znak
(statistický) |
Je vnější
měřitelnou vlastností statistické jednotky, která je předmětem zkoumání. |
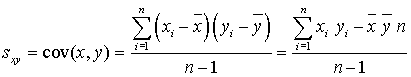

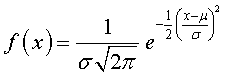
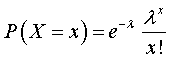

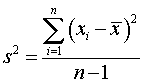

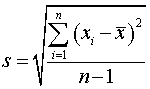

Další informace
Statistické postupy v laboratorní medicíně
Bedřich Friedecký, Josef Kratochvíla, recenzoval Zdenek Kubíček
.